2026. 10. 1. 22:16ㆍ크래프톤 정글/포스팅
지금 위치: 파트 1이 "왜 allocator가 필요한가"였다면, 여기서는 "그 일이 왜 어려운가"를 다룹니다.
이번 파트의 질문: allocator는 무엇을 잘해야 하고, 무엇이 그것을 방해하며, 그래서 무엇을 결정해야 하는가?
1. allocator가 풀어야 하는 조건 (제약)
allocator는 아무렇게나 일할 수 없고, 아래 제약 안에서 일해야 합니다
| 제약 | 의미 | 이게 왜 어렵게 만드나 |
| 1. 임의의 요청 순서 | 할당/해제가 어떤 순서로 올지 모름 (짝이 맞거나 중첩된다는 보장도 없음) |
미래를 예측해서 최적 배치를 짤 수 없다 |
| 2. 즉시 응답 | 요청을 모아서 한꺼번에 처리 불가 | 지금 당장 결정해야 한다 |
| 3. 힙만 사용 | allocator가 쓰는 자료구조도 힙 안에 저장 | 관리 정보도 공간을 차지한다 |
| 4. 정렬 조건 지켜야함 | 어떤 타입도 담을 수 있게 정렬 | 패딩이 생긴다 |
| 5. 할당된 블록은 못 건드림 | 한번 준 블록은 수정·이동 불가 → compaction 불가 | 흩어진 조각을 모아서 정리할 수 없다 |
핵심은 마지막 둘입니다. "미래(요청 순서)를 모르고, 한번 준 건 옮길 수 없다"
이 때문에 아래 단편화가 생기면 되돌리기 어렵습니다.
2. allocator의 두 가지 목표, 그리고 충돌
목표 1: Throughput (처리량) = 단위 시간당 처리하는 요청 수.
예를 들어 1초에 할당 500번 + 해제 500번을 처리하면 초당 1,000 operations입니다. 요청당 평균 시간을 줄이면 올라갑니다.
목표 2: Peak utilization (최대 메모리 활용도) = 애플리케이션이 실제로 쓴 데이터량 대비 힙이 얼마나 커졌나.
- payload: 애플리케이션이 요청한 크기 (malloc(p)의 p바이트)
- aggregate payload P_k: k번째 요청 이후 현재 할당된 블록들의 payload 합
- H_k: 현재 힙 크기 (줄어들지 않고 커지기만 함)
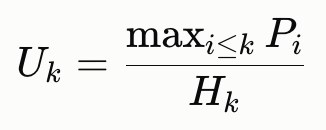
말로 풀면 최대 메모리 활용도는 "지금까지 가장 많이 쓴 순간의 payload 합 ÷ 현재 힙 크기"입니다. 1에 가까울수록 힙이 알차게 쓰인 겁니다. 이 식을 외울 필요는 없고, "힙이 payload 대비 얼마나 부풀었나"라는 감각만 잡으시면 됩니다.
두가지 목표는 충돌합니다.
- 낭비를 줄이려면 빈 블록을 찾고, 쪼개고, 합치는 일을 더 해야 하고, 그만큼 시간이 듭니다.
- 반대로 해제된 블록을 재사용하지 않고 힙 끝에서만 계속 잘라주면 가장 빠르지만, 힙이 금방 부풀어 utilization이 형편없어집니다.
따라서 allocator 설계의 궁극적인 목표는 이 둘 사이에서 균형을 잡는 것입니다.
3. 낭비의 정체: 단편화 (fragmentation)
utilization을 망치는 주범은 단편화, 즉 "쓸 수 있는 메모리가 있는데 요청에 쓰이지 못하는 상태"입니다.
내부 단편화와 외부 단편화 두 종류가 있습니다.
내부 단편화 (internal fragmentation)
할당된 블록이 payload보다 큰 경우 블록 안쪽의 낭비입니다.
생기는 이유는 대표적으로 둘입니다.
- 정렬을 맞추려고 크기를 올림 (5워드 요청 → 정렬 맞추려고 6워드 할당)
- 블록에 최소 크기가 정해져 있음 (예: malloc(1)을 해도 16바이트 블록)
- 헤더/푸터 같은 관리 정보도 payload가 아니므로 이 차이에 포함됨
내부 단편화는 계산이 쉽습니다.
각 할당 블록의 (블록 크기 − payload)를 합치면 되고, 이전 요청 패턴과 allocator 구현만으로 정해집니다.
외부 단편화 (external fragmentation)
빈 공간의 합은 충분한데, 하나로 이어진 빈 블록이 요청보다 작은 경우입니다. 블록 바깥의 낭비입니다.
힙:  [A: 할당][ free 2 ][B: 할당][ free 2 ][C: 할당][ free 4 ]
                  ↑                  ↑
        빈 공간 합계 = 2+2+4 = 8워드
        하지만 8워드를 요청하면?  → 이어진 8워드가 없어서 할당을 못해줌
각각의 빈 공간 합은 8워드인데 3 블록에 나뉘어 있어서, 8워드 요청을 못 받아주고 sbrk로 힙을 늘려야 합니다.
외부 단편화는 계산이 어렵습니다. 같은 힙 상태라도 미래 요청에 따라 문제인지 아닌지가 달라지기 때문입니다.
- 빈 블록이 전부 4워드이고, 앞으로 요청이 모두 4워드 이하라면 → 문제 없음
- 앞으로 4워드보다 큰 요청이 하나라도 오면 → 외부 단편화
미래는 모르므로 정확히 측정도, 완벽히 예방도 못 합니다.
그래서 allocator는 "작은 빈 블록 여러 개보다 큰 빈 블록 몇 개를 유지하자"는 휴리스틱(어림 규칙)을 씁니다.
정리
| 내부 단편화 | 외부 단편화 | |
| 낭비가 있는 곳 | 할당된 블록 안 | 블록들 사이의 빈 공간 |
| 원인 | 정렬, 최소 크기, 관리 정보, 큰 블록을 통째로 줌 | 요청·해제가 반복되며 빈 블록이 쪼개져 흩어짐 |
| 측정 | 쉬움 | 미래 요청에 의존해 어려움 |
| 줄이는 도구 | 분할(splitting) | 배치 정책(placement), 병합(coalescing) |
4. 그래서 allocator는 네 가지를 결정해야 한다
처리량(속도)을 높이고 활용도를 높이려면 allocator는 아래 네 가지를 결정해야 합니다.
단편화와 연결하면 각 결정이 왜 존재하는지가 보입니다.
| 결정 | 질문 | 어떤 문제를 겨냥하는가? |
| ① 추적 (free block organization) | 빈 블록을 어떻게 기록하고 찾지? | 모든 결정의 토대. 속도(찾는 시간)에도 영향 |
| ② 배치 (placement) | 요청이 오면 어느 빈 블록을 고르지? | 외부 단편화, 속도 |
| ③ 분할 (splitting) | 고른 블록이 너무 크면 남은 부분은? | 내부 단편화 |
| ④ 병합 (coalescing) | 방금 해제한 블록은 이웃과 합칠까? | 외부 단편화 |
책은 배치·분할·병합은 여러 추적 방식에 공통으로 쓰이는 기법이므로 가장 단순한 추적 방식(implicit free list)을 가지고 설명합니다.
allocator는 "요청 순서를 모르고, 한번 준 블록을 옮길 수 없다"는 제약 아래에서
빠르게(throughput), 낭비 없이(peak utilization) 일해야 하는데, 둘은 충돌한다.
→ 낭비의 원인은 단편화이며, 블록 안쪽의 내부 단편화와 블록 사이의 외부 단편화가 있다.
외부 단편화는 미래 요청에 따라 문제 여부가 달라져 완벽히 막을 수 없어서, 작은 빈 블록이 흩어지지 않게 하는 휴리스틱을 쓴다.
→ 이를 위해 allocator는 추적, 배치, 분할, 병합의 네 가지를 결정해야 한다.